2026-09-10_AVGO_Hock-Tan探討生成式AI投資回報
博通 Hock Tan 於高盛會議探討生成式 AI 投資回報
☘️ Article
孟恭觀點
- Broadcom @GS
- 滿有趣的分享,Hock 認為 winner takes all,以及站隊閉鎖模型
- Broadcom 內部認真導入生成式 AI 一年,3 萬名工程師中 1.5 萬人參與,有 Mythos Preview 完整存取權。問題在於找到 ROI 明確且顯著的用例,Hock 認為多數企業都卡在這
- 先進製程晶片一次 respin 要 6 個月、3000 萬美元,用 OpenAI/Anthropic/Gemini 工具消除 respin 就是明確回報
- Hock 認為沒有第二名的空間,只要 LLM 持續指數級進步,價值就流向做出最佳前沿模型的人
- 1 GW 可產生約 300 億美元 ARR,營運成本約 100 億/年 > 200 億歸模型與應用層,剩下 100 億由電力、雲端、晶片、記憶體業者搶
- OpenAI 一年內做出 Jalapeno,目前已在做 Jalapeno 之後兩個世代
- 面對客戶 (含 Google) 自研的挑戰,博通認為高速 SerDes、Die 2 die 低功耗互連、先進封裝都是護城河
- 與 Google 合作超過 10 年,每一代 TPU 都參與;4 月簽的 LTA 強化關係
- 上週財報給的預期皆為供給受限估計,若疏通就更高
- power ready 的廠址是後面的瓶頸
- 前沿模型花 1000 億賺 1200 億,開放權重模型花 1000 億只賺 300 億,Hock 質疑其經濟模型
✍️ Abstract
三句話總結
- 企業難在取得具體回報:Broadcom 導入生成式 AI 一年後,企業難題並非導入技術,而是尋找明確的 ROI 用例。
- 如:以 AI 降低先進晶片 Respin,直接省下 數千萬美元、6 個月開發時間。
- 前沿模型形成贏家多拿:閉源前沿模型具備 贏家多拿 (Winner-Takes-Most) 結構,只要模型能力持續快速進步,最大經濟價值將集中於最領先的 模型、應用層,開放權重模型的商業模式仍有待驗證。
- 先進互連構築護城河:Broadcom 的核心護城河在於 高速 SerDes、die-to-die 互連、先進封裝、多年客製化 XPU 經驗,目前 AI 需求 > 供給,而未來更大瓶頸可能由晶片供應轉向 power-ready 資料中心場址。
博通 Hock Tan 於高盛會議探討生成式 AI 投資回報與前沿模型贏家通吃趨勢
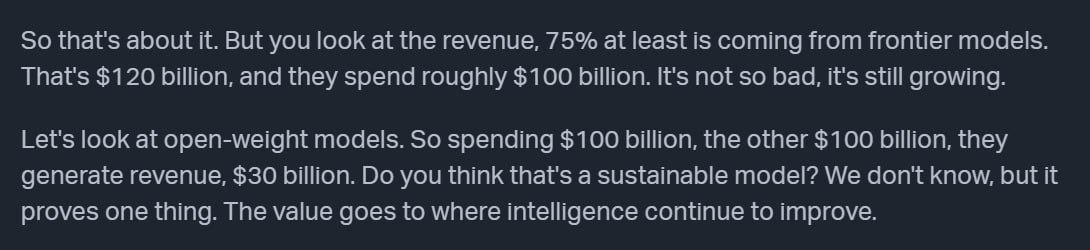
- 大致上就是這樣。但如果你看營收,至少有 75% 來自前沿模型 (frontier models)。
- 這大約是 1,200 億美元營收,而它們大約投入了 1,000 億美元。這其實不算太差,而且還在持續成長。
- 再來看看開放權重模型 (open-weight models)。它們同樣花了大約 1,000 億美元,卻只產生約 300 億美元營收。
- 你覺得這是一個可持續的商業模式嗎?我們不知道。
- 但這至少證明了一件事:價值會流向「智慧能力持續提升」的地方。
孟恭觀點分析
- 企業難獲明確投資回報:Broadcom 內部導入生成式 AI 1 年,動員 3 萬名工程師中的 1.5 萬人,並取得 Mythos Preview 完整存取權,指出多數企業當前瓶頸在於尋找 明確、顯著 的 ROI 用例。
- 消除 Respin 確立明確回報:先進製程晶片 1 次 Respin (重新改版投片) 需 耗時 6 個月、耗資 3000 萬美元,運用 OpenAI、Anthropic、Gemini 等工具在前端輔助驗證,消除晶片改版失誤,即可直接省下上述 時程、鉅額費用,為企業確立明確的 ROI。
- 前沿模型形成贏家全拿:市場缺乏第 2 名生存空間,只要 LLM 持續指數級進步,經濟價值將全數流向打造最佳前沿模型的開發者。
- 前沿模型展現營收優勢:前沿模型支出 1000 億美元可創造 1200 億美元營收,開放權重模型同樣支出 1000 億美元僅獲 300 億美元,使其商業模式持續性備受質疑。
- 模型層奪取多數利潤:Hock 估算,每 1 GW AI 算力可支撐約 300 億美元 ARR,其中約 100 億美元會流向 電力、雲端、晶片、記憶體 等基礎設施成本,剩餘約 200 億美元的收入空間則由 模型、應用 層捕獲
- 自研晶片加速世代迭代:OpenAI 於 1 年內完成 Jalapeno 晶片,且已展開後續 2 個世代的研發工作。
- 先進互連構築護城河:面對包含 Google 在內的客戶自研晶片挑戰,Broadcom 將 高速 SerDes、Die 2 die 低功耗互連、先進封裝 視為核心競爭護城河。
- 長期協議深化客戶合作:Broadcom、Google 合作超過 10 年,參與歷代 TPU 開發,4 月簽署的 LTA 進一步強化了雙方合作關係。
- 供電廠址成為主要瓶頸:財報指引預期皆基於供給受限估計,若產能疏通表現將更佳,目前後端擴張的主要瓶頸在於具備供電能力的 power-ready 廠址。
專有名詞
- ROI (Return on Investment):投資報酬率,衡量投入成本能帶來多少效益,多數企業導入生成式 AI 的難點,在於找到 ROI 明確且顯著的應用。
- Respin:晶片重新改版,晶片製造完成後若發現設計缺陷,需修改設計並重新製作光罩投片,先進製程 1 次 Respin 可能 耗時 6 個月、成本 3000 萬美元。
- LLM (Large Language Model):大型語言模型,若 LLM 能力持續快速進步,經濟價值將更集中於能力最強的前沿模型開發者。
- ARR (Annual Recurring Revenue):年度經常性收入,將持續性收入換算為 1 年規模,1 GW AI 運算基礎設施可支撐 300 億美元 ARR。
- SerDes (Serializer/Deserializer):序列器/解序列器,負責高速資料傳輸,是 Broadcom 在客製化 AI 晶片領域的重要技術護城河之一。
- Die-to-Die Interconnect:裸晶對裸晶互連,讓同一封裝內多顆裸晶,以 高速、低功耗 方式傳輸資料,是 Multi-Die 架構的核心技術。
- Advanced Packaging:先進封裝,透過 2.5D、3D、Chiplet 等技術,整合多顆 裸晶、記憶體,是 Broadcom 客製化 AI 晶片的重要競爭優勢之一。
- TPU (Tensor Processing Unit):張量處理單元,Google 自研的 AI 加速晶片,Broadcom、Google 合作超過 10 年,參與歷代 TPU 開發。
- LTA (Long-Term Agreement):長期合作協議,Broadcom、Google 於 2026 年 4 月簽署,用於深化未來 TPU、AI Networking 等長期合作。
- Frontier Models:前沿模型,代表當下能力最強,且 訓練、推論 投入最高的一批 AI 模型,投入 1000 億美元運算成本,可創造 1200 億美元收入。
- Open-Weight Models:開放權重模型,允許外部取得模型權重,並自行 部署/微調,投入 1000 億美元運算成本,但目前僅創造 300 億美元收入。